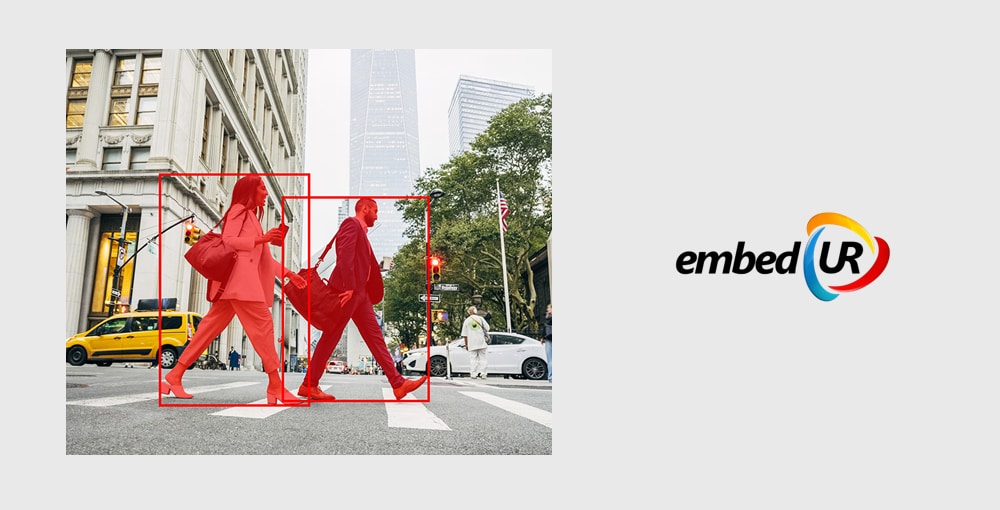
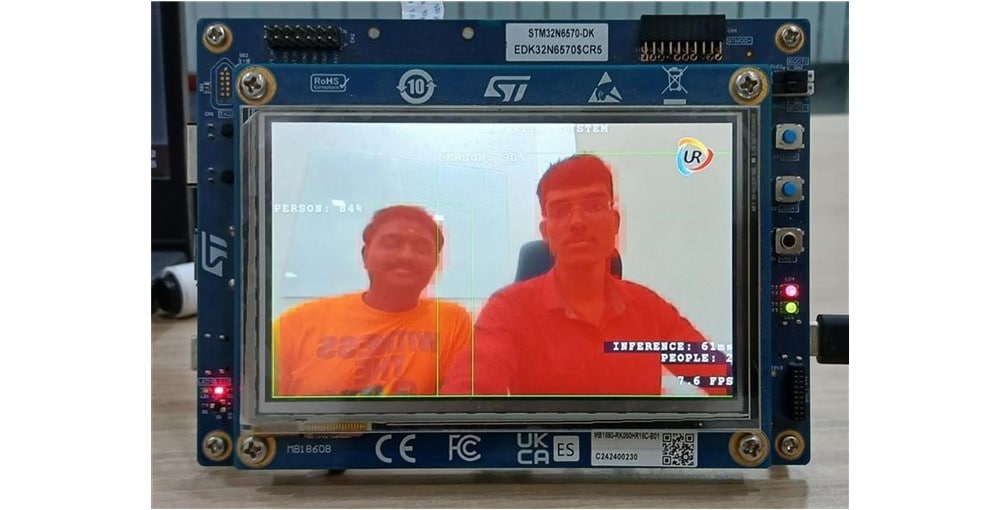
視覚ベースの小型製品の設者は、単純なモーション検知を超える機能をますます必要としています。 そうしたシステムは、コスト効率、エネルギー効率、プライバシー規制対応を維持しながら、シーン内に存在する人物や物体を認識できなければなりません。embedUR社 は、最適化されたインスタンス・セグメンテーション ・モデルをSTM32N6に直接展開することで、クラウド接続や外部アクセラレータを一切必要とすることなく、完全にエッジ上でリアルタイム人物検出とピクセル・レベルのセグメンテーションを14 FPS で実現しました。
アプリケーション・ドメイン:
- スマート・ホーム・カメラ
- 産業用安全モニタ
- 小売分析システム
- ロボティクスおよびドローン
- インタラクティブ・コンスーマ機器(スマート・ミラー、ディスプレイなど)
アプローチ
屋内監視向けの小型AIビジョン製品を開発しているあるお客様は、自社システムにシーン・コンテキスト とビジュアル・インテリジェンス を加えることを目指していました。目標は、ビデオ・フィード内の領域(人物、背景、物体など)を識別・分離することで、照明の自動制御、、セキュリティ・アラート、デバイス連携といった、よりスマートな自動化を実現することでした。コストや製品サイズの制約により、ソリューションはマイクロコントローラ上で直接動作する必要がありました。
従来のアプローチにはそれぞれ大きな制約があります。サーバまたはクラウド・ベースのセグメンテーション は、解像度の高い出力が得られるものの接続が必要であり、プライバシー・リスクをもたらすほか、継続的なクラウド・コストも発生します。PIRセンサやモーション・センサ は、消費電力が非常に少ないものの視覚的理解能力に欠けており、シーンの種類やオブジェクト・クラスを検出できません。高性能AIアクセラレータ は高速かつ堅牢ですが、リソースに制約のある組み込み機器では、コストやサイズの面で適していません。
embedUR社は、セマンティック・セグメンテーション・モデルを量子化および最適化し、STM32N6上で動作させることで、小型で電力効率に優れた構成でリアルタイムの映像認識を実現しました。このモデルは、低消費電力カメラの映像から直接ピクセル・レベルの分類を行います。
この組み込みAIの手法がもたらす主なメリット:
- 外部アクセラレータが不要:セグメンテーション処理の全工程をSTM32N6単体で実行できるため、BOMから外付け部品を削減
- リアルタイム推論:フレームあたり100ms未満で処理
- ピクセル・レベルのシーン認識:動きだけでなく、各人物の存在、位置、輪郭を正確に検出
- 電力効率に優れた設計:バッテリ駆動や常時動作の製品の制約に対応
- コンパクトな統合:狭いスペースへのカメラ・モジュールの実装を実現
- プライバシー・バイ・デザイン:ビデオ・フレームはデバイス内で処理され、外部へ送信されることはありません
アプリケーションの概要
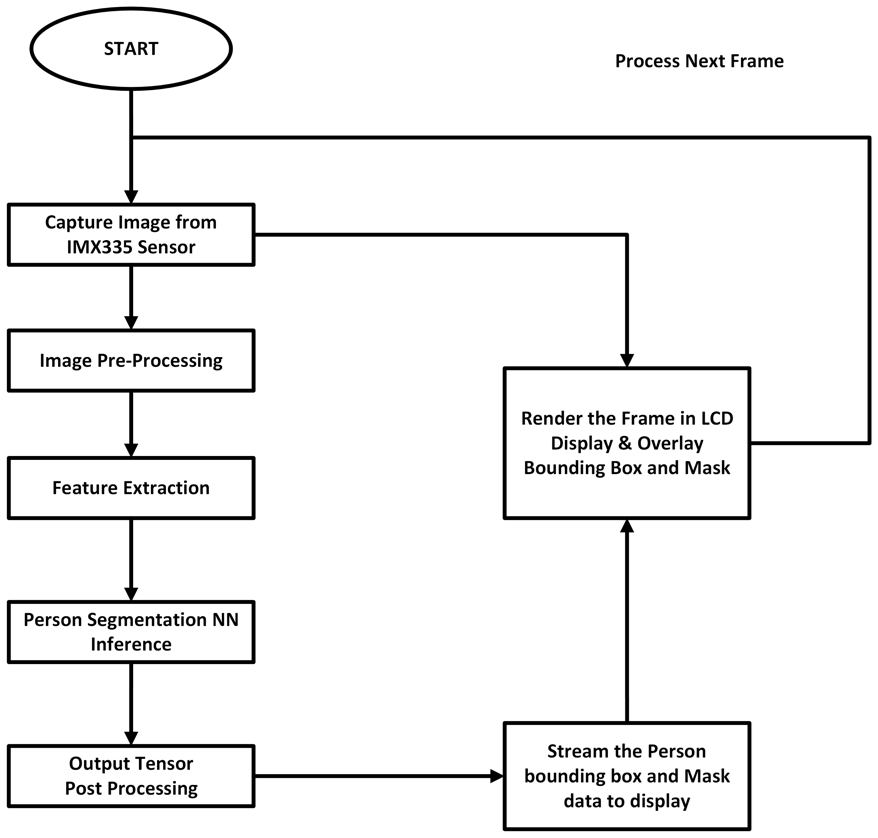
このシステムは、STM32N6に接続されたカメラ・センサから映像をリアルタイムに取得し、セグメンテーション・パイプラインを通じて処理します。
1. フレーム・キャプチャとバッファリング
各ビデオ・フレームをメモリ内で複製します。一方のコピーは表示パイプラインへ送られ、ダブル・バッファリングを用いた描画処理により、滑らかでちらつきの無いリアルタイム表示を実現します。もう一方のコピーはAI処理パスに送ります。
2. 前処理
フレームをニューラル・ネットワーク推論に必要な224x224の解像度にダウンスケールして前処理します。
3. インスタンス・セグメンテーション推論
デバイスに展開したYOLACTニューラル・ネットワークに前処理済みフレームを渡します。このモデルは、物体検出(バウンディング・ボックスおよび信頼度スコアの算出)と、インスタンス・セグメンテーション(学習済みのプロトタイプ・マスク およびインスタンスごとの係数を用いた、検出された各人物固有のマスク生成)という、2つの主な処理を実行します。
4. 後処理と表示
Non-Maximum Suppression(NMS)によって検出結果を絞り込み、マスクの統合としきい値処理によって背景から人物領域を抽出します。検出された人数およびセグメンテーション・マスクを元のフレームに重ね合わせて、ディスプレイにリアルタイム描画します。
技術情報
このソリューションは、組み込みデプロイに最適化されたリアルタイム・インスタンス・セグメンテーション・ニューラル・ネットワークであるYOLACTをベースにしています。従来のピクセル単位のセグメンテーション・ネットワークとは異なり、グローバル・プロトタイプ・マスクとインスタンスごとの係数を組み合わせることで、検出とマスク生成を分離します。このアーキテクチャにより、セグメンテーション精度を維持しながら、演算の複雑さを大幅に低減します。
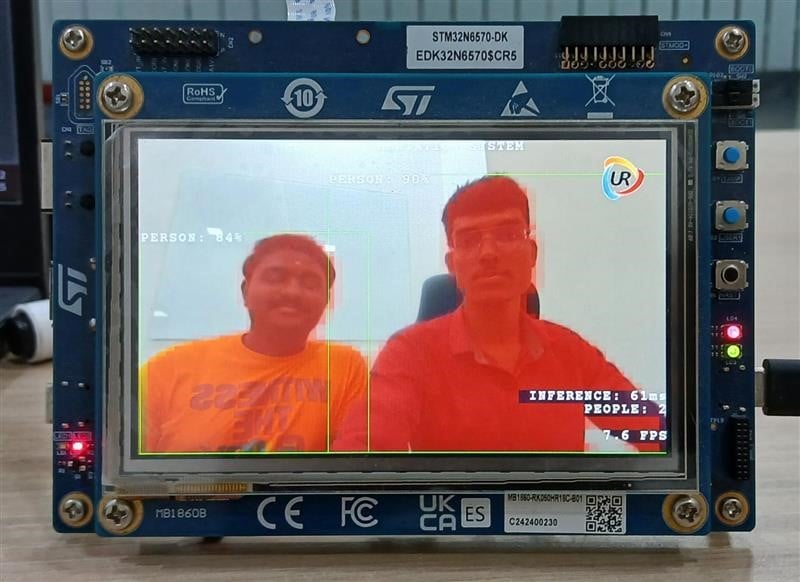
上の画像は、人物の検出およびセグメンテーション・プロセスを示しています。フレーム内に人物が検出されると、その存在が検証され、人物ごとにセグメンテーション・マスクが生成されます。フレーム内で識別された人物の総数もリアルタイム表示されます。
ST Edge AIツールを使用してモデルを量子化し、STM32N6シリーズ・マイクロコントローラにデプロイすることで、AIパイプライン全体をローカル実行できます。
- リアルタイム性能:フレーム内に複数の人物が存在する場合でも精度を維持
- 高いセグメンテーション精度:軽量なプロトタイプ・ベースのマスク生成手法を採用
- 低遅延処理:クラウドへのデータ転送を必要とせず、すべての処理をオンデバイスで実行
- スムーズなディスプレイ出力:ダブル・バッファ・レンダリングによる描画により、シームレスなユーザ体験を実現
センサ
このアプリケーションは、IMX335 CMOSイメージ・センサを搭載したMB1854B カメラ・モジュールを使用しています。画質は、インスタンス・セグメンテーションにおけるマスク精度に直接影響します。一貫した色再現性と輪郭が鮮明な映像は、ネットワークが人物と背景の境界を明確に識別するのに役立ちます。また、フレーム間で露出が安定していると、複数の人物がシーン内を移動してもマスクの輪郭を安定した状態に保つことができます。IMX335は、こうした高精細に加えて、信頼性の高い低照度 性能を発揮します。そのため、モデルに送られるRGBフレームは多様な屋内照明環境で信頼性を保ちます。
モデルと結果
モデル:
- YOLACT(インスタンス・セグメンテーション)
- 入力サイズ:224 x 224
- ModelNova(embedUR社)によりSTM32N6に最適化および量子化
結果:
- 推論時間:61ms
- 後処理時間:1ms
- FPS:~14
- デプロイメント:STM32N6シリーズ上での完全オンデバイス実装
ソフトウェア・ツール
- STM32Cube AI Studio:ニューラル・ネットワークの変換および実装用
- ST Edge AI Core コマンド・ライン・インタフェース
- STM32CubeIDE:アプリケーション開発およびデバッグ用
- STM32CubeProgrammer: ターゲットへのプログラム書き込み用
開発リソース
STM32Cube AI Studioで最適化
STM32Cube AI Studioは、STM32上で動作させるニューラル・ネットワーク・モデルを評価、最適化、コンパイルするために設計されたデスクトップ・ツールです。ニューラル・ネットワーク処理ユニット(NPU)Neural-ARTアクセラレータ用のコンパイルにも完全対応しています。STのAIソリューションとして提供していたX-CUBE-AIに代わるツールであり、新しいSTM32デバイスにも対応しています。
STM32N6シリーズに最適
Arm® Cortex®‑Mプロセッサをベースとする32bit汎用マイクロコントローラのSTM32ファミリは、より柔軟かつ自由なアプリケーション開発を実現します。高性能、リアルタイムの処理能力、デジタル信号処理(DSP)、低消費電力 / 低電圧動作、コネクティビティなどのさまざまな機能を集積した製品により、開発をサポートします。